技术说明
Cloak 技术原理
cloak 技术的全部难点在一句话里:在什么时刻、用什么证据,判断这次访问是不是审核方。 时刻决定了证据,证据决定了准确率。这页把这条链讲清楚。
判定时刻决定了你手上有什么
重定向型必须在发出第一个字节之前决定,那一刻只有 IP、TLS 握手和 HTTP 头。 页内型可以等页面跑起来,多一层浏览器自述。看起来页内型信息更多,但它要用停留时间换 -- 而自动抓取的停留时间中位数是 0.1 秒。
| 信号 | 什么时候可用 | 稳不稳定 |
|---|---|---|
| IP 网段归属 | 收到请求那一刻 | 最稳。平台自有网段变动很慢,且可查 |
| ASN | 收到请求那一刻 | 较稳,但 IPv6 段常解析不出,必须带网段兜底 |
| 自报 UA token | 收到请求那一刻 | 易伪造,只能当确认不能当判据 |
| 请求头完整度 | 收到请求那一刻 | 稳。浏览器与抓取器的差别是结构性的 |
| TLS 握手特征 | 握手完成时 | 较稳,但客户端库升级会漂 |
| 浏览器环境自述 | 页面加载并停留数秒后 | 精度高但覆盖率极低,且平台一改配置就静默失效 |
这一层的覆盖率天生很低:要访客停留够久才拿得到判定。所以它的作用是在少量访问上产出高置信标签, 再把命中的 IP 提取成动态名单,回去覆盖同一 IP 上那些没跑脚本的访问,而不是拿来做统计。
这个品类共同的盲区
所有只看请求本身的过滤器 - IP、网络、请求头 - 都只能接住「自己报身份」的那批审核流量。 真正让账号出事的是另一批:从普通云主机过来,请求头完整、UA 是正常的 Android 或 Windows Chrome, 整条请求挑不出一个破绽。
在投流量里我们确实见到这样的会话,来自普通云服务商。 服务端视角下它们和真实访客完全一样 - 也就是说,每一个在页面渲染前做判定的过滤器, 都把报价页原样发给了它们。
能把这个访客和买家分开的只有一样东西:他的浏览器跑在什么环境里。 而环境证据要页面跑起来之后才存在 - 这就是判定必须做在页面上而不是跳转前的全部理由。
我们在这一层带来的东西
一套跨层一致性检查的浏览器环境引擎。它原本是为反方向的问题造的: 判断一个浏览器有没有在谎报自己是什么。而一个审核环境正是一台虚拟机在把自己说成一部手机 - 同一个问题,从另一边问。
这不是让你凭信任接受的说法。关于这一层我们只说一件与品类有关、与自己无关的事:
最后那一行才是重点。这个品类当成 bot 判据用的自动化标记命中了 44 次, 一次都不是审核流量 - 那是一批与审核零重合的自动化农场。 这一层拼的不是规则条数,是规则打在不打得中的那个人群上。
一次判定,别只花在一次访问上
浏览器判定很贵:访客要停留好几秒探针才跑得完,所以它既精准又稀有。 把它当成「这一次访问的结论」,等于把它绝大部分价值扔掉。
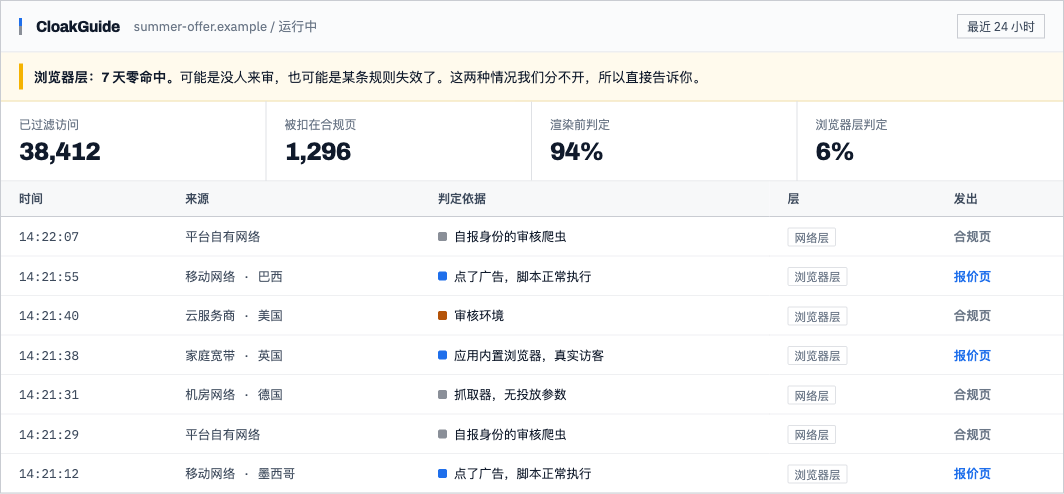
所以一个被确认的审核环境会变成那个 IP 的标签,此后来自同一地址的每一次请求都被覆盖 - 包括 0.1 秒就走、永远不会执行脚本的那些。 这是从一个稀有的高精度信号走到全量覆盖的唯一通路,也是我们认为真正属于自己的那一块。
我们不会声称的事
归因不了的真人审核员
真浏览器、真机器、行为正常、地址我们归因不了。这个品类没有任何一家挡得住,我们也一样。 诚实的写法是把它写出来,而不是给你报一个数。
规则永远有效
这一层的任何规则,一旦平台绕开它就会静默失效。 而零命中和「最近没人审」在数据上分不开,所以每个账号都带命中数报警, 不是一块没人看的面板。
你的账号安全
那个决定归平台。任何给你一个存活率数字的卖家,卖的都是他控制不了的东西。
过滤器是难的那部分
难的是你的合规页。我们见过审核员在一个页面上待了好几分钟,把整个结账流程走完。经不起这个的页面,前面挂什么都没用。
定价
入门
$49 / 月
- 1 个站点
- 每月 50,000 次过滤访问
单个 offer、单个落地页、单个流量源。
进阶
$99 / 月
- 5 个站点
- 每月 250,000 次过滤访问
同时跑多个 offer,跨一个以上平台。
规模
$199 / 月
- 站点数不限
- 每月 1,000,000 次过滤访问
代投与为多个广告主投放的团队。
常见问题
- cloak 技术到底在判什么?
- 判「这个请求背后是不是平台的人」。注意它和「这个浏览器有没有撒谎」不是同一个判定 -- 后者是反检测领域那套跨层一致性检查。一个用真 Chrome、真机器的人类审核员环境完全自洽,那套检查一条都不会触发。
- 为什么 IP 归属比指纹更管用?
- 因为审核方最稳定的属性是他从哪来,不是他的浏览器长什么样。一个用真 Chrome、真机器的人类审核员,环境本来就自洽,所有一致性检查都不会触发;而他的 IP 归属是藏不掉的。所以第一层判网络,第二层才判浏览器 - 反过来的做法是把简单的一半解两遍。
- ASN 判定有什么坑?
- 入口层的 ASN 解析对某些 IPv6 段会直接返回空。实测 Meta 最大的那个 IPv6 段上 247 行请求,ASN 全是 null -- 只按 ASN 号查会得到「零访问」的假象,量最大的那一支整支漏掉。任何基于 ASN 的判定都必须带一份官方 IP 段兜底。
- 自动化检测能不能复用?
- 不能混成一个分数。实测里 webdriver 为真的 44 个样本,时区集中在 Asia/Shanghai、GPU 是软件渲染、来自某个香港机房网段,与平台审核零重合。「跑 JS 的自动化」和「平台审核」在数据上是两个完全不同的簇。
加入等待名单
还没有可用的账号。留个邮箱,开放内测时我们通知你,并附上你投放的流量源对应的配置说明。